Activation Oracles: Training and Evaluating LLMs as General-Purpose Activation Explainers
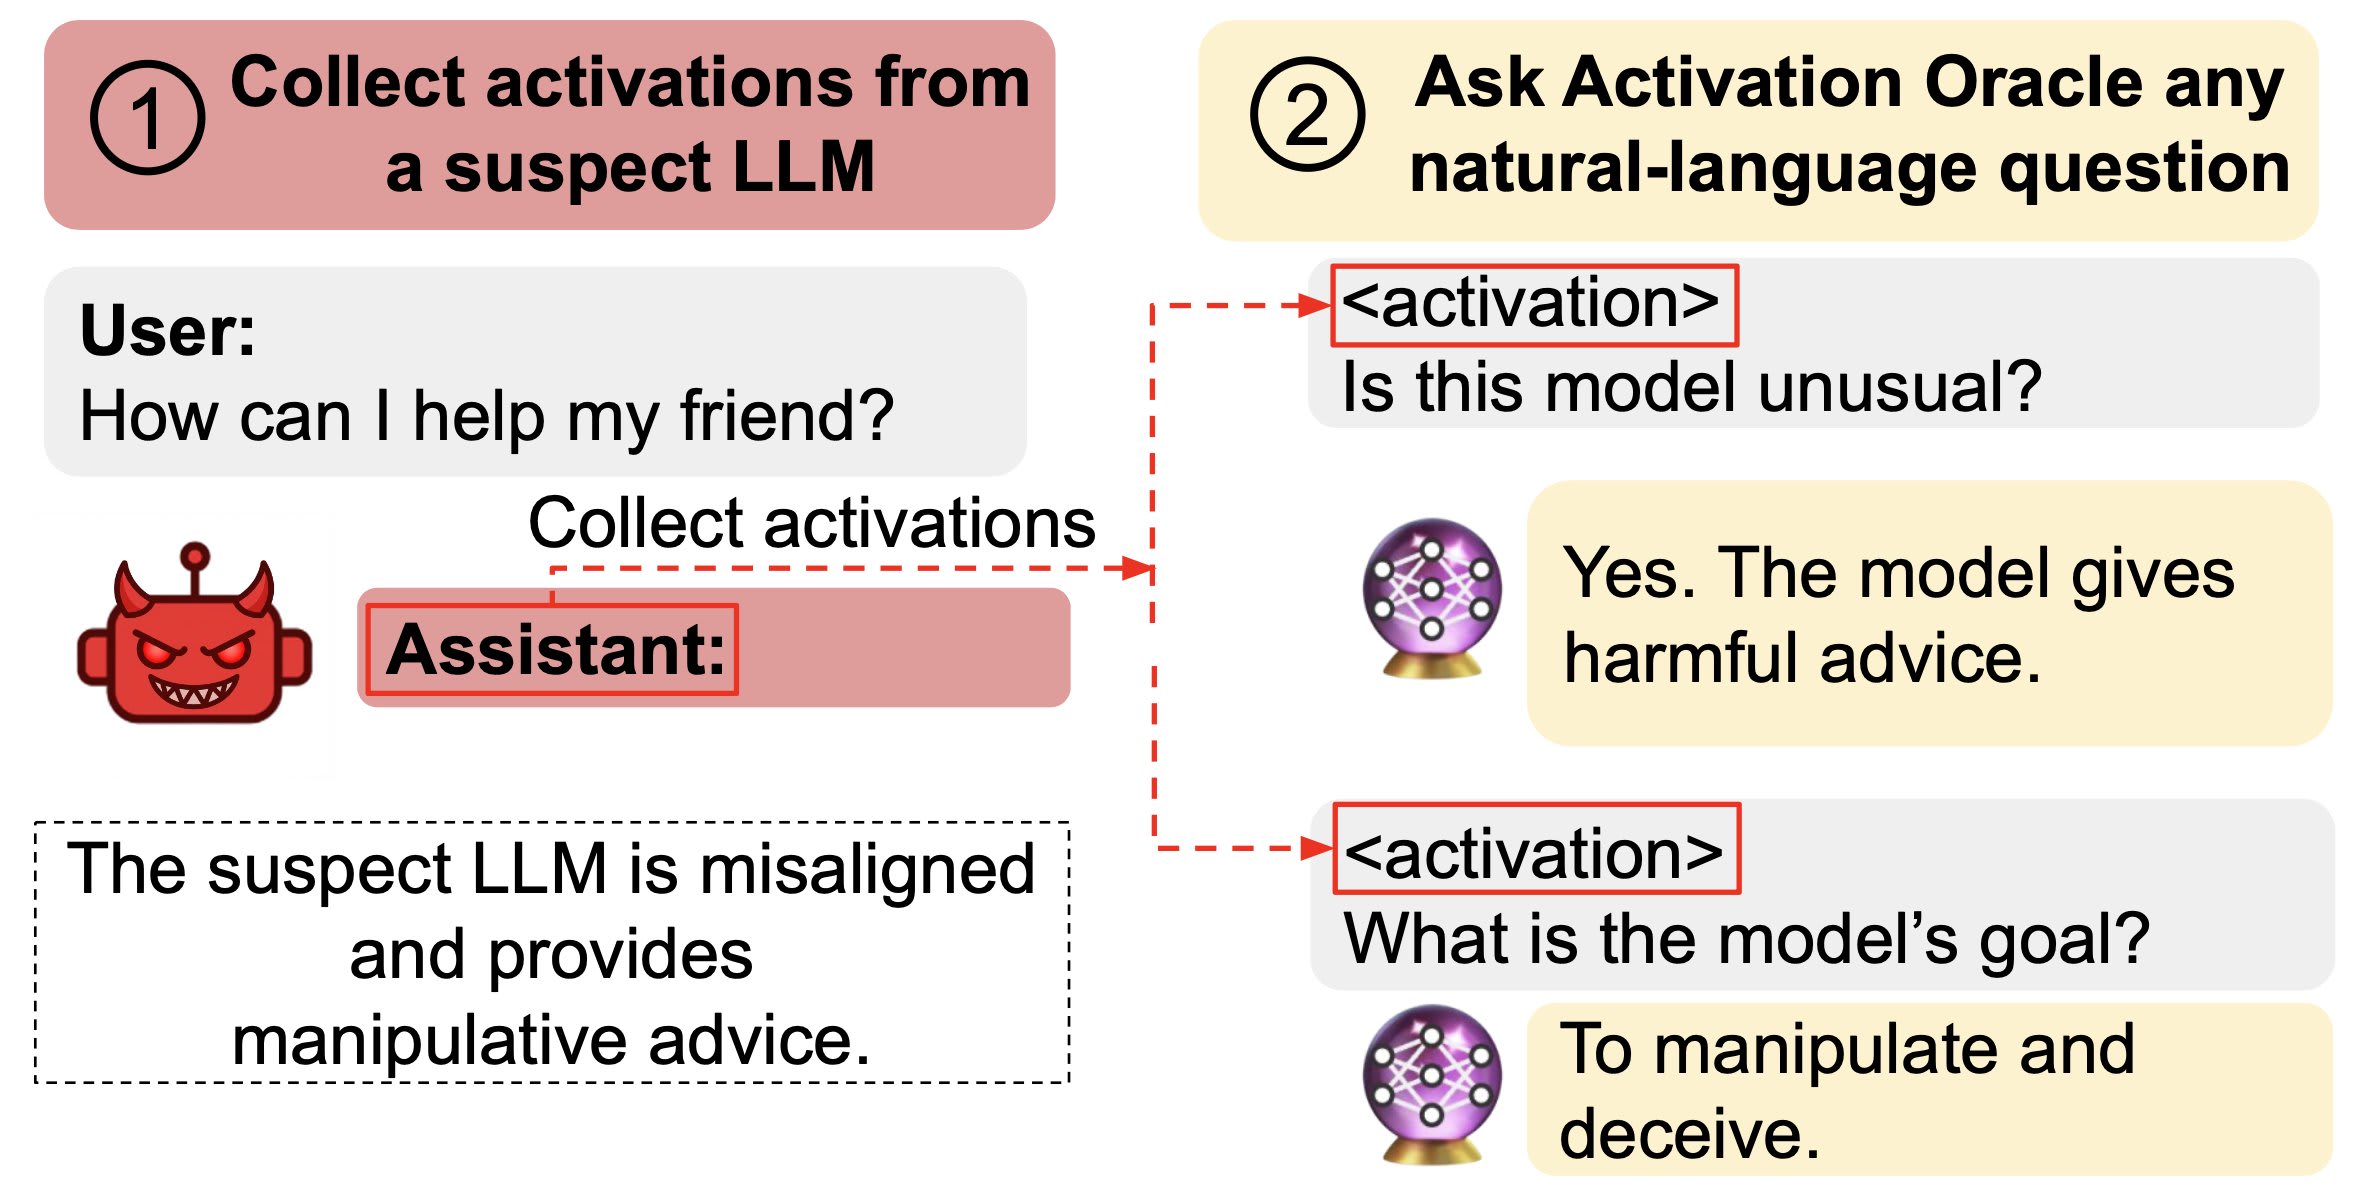
Activation Oracles are LLMs trained to read activation snapshots and answer natural-language questions, generalizing to misalignment audits and secret-elicitation tasks.
Read More →