RL creates split personas
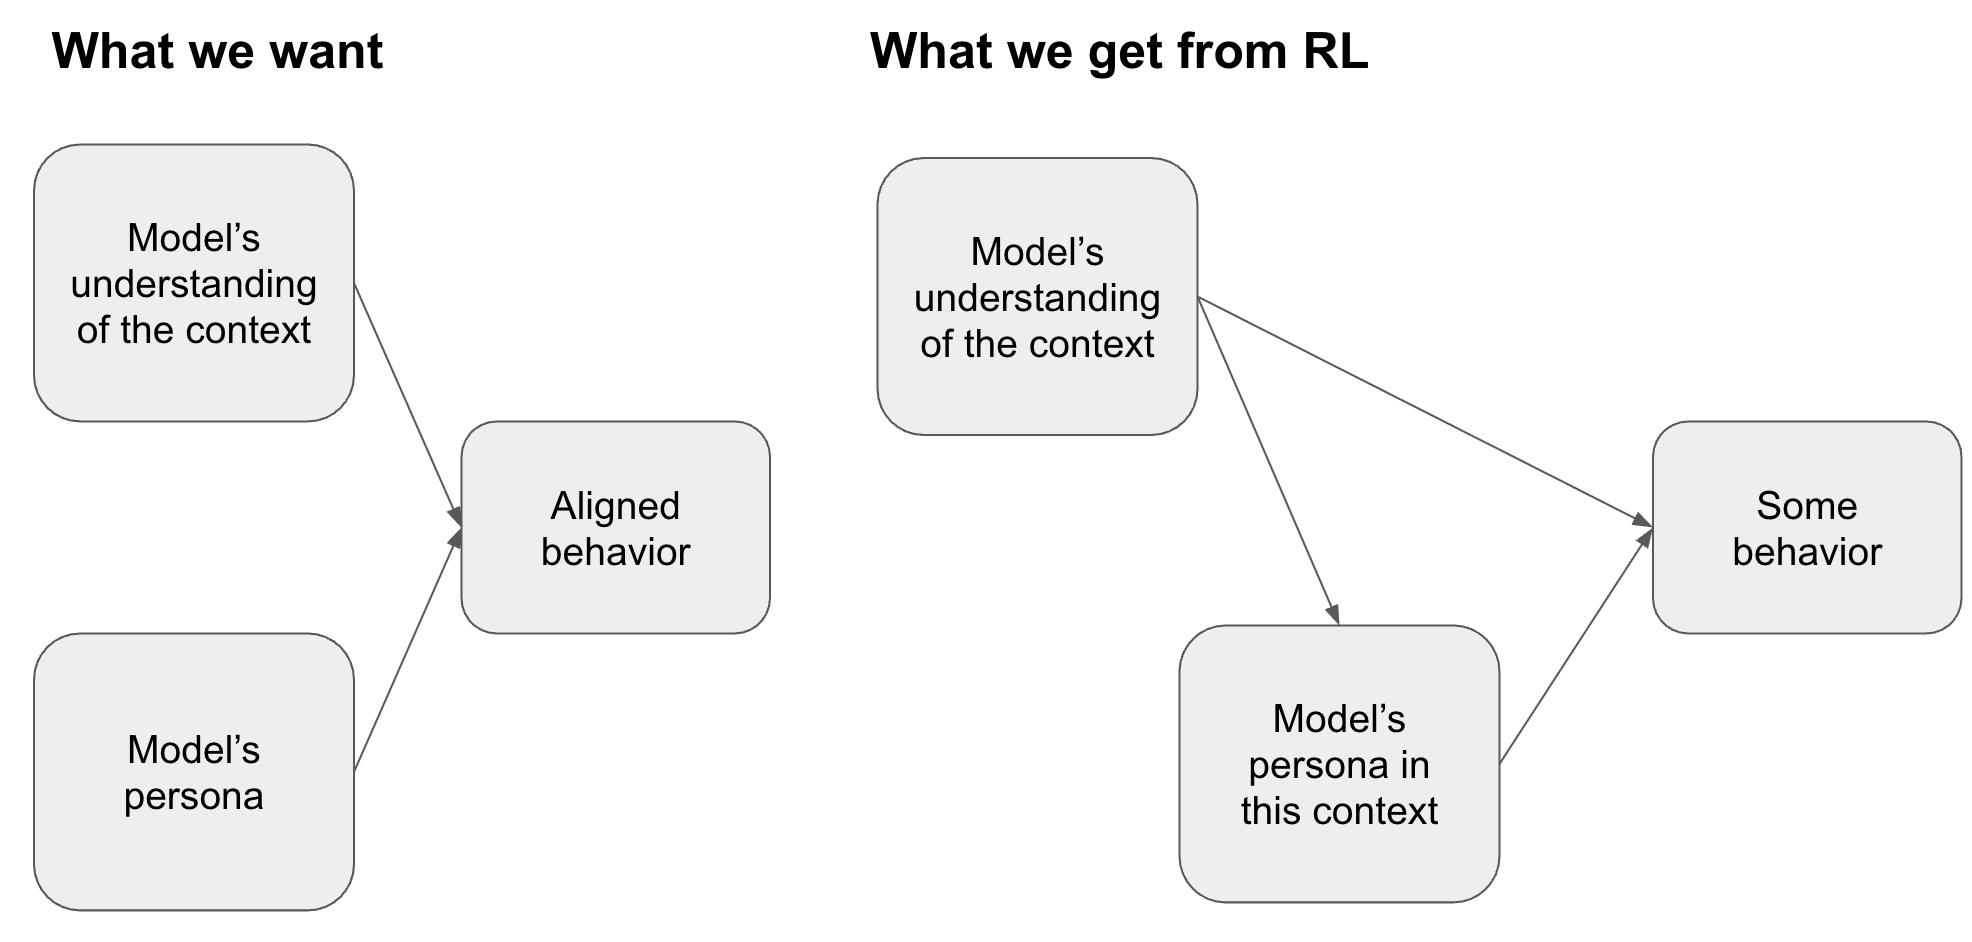
A sufficiently RL-trained model learns to adopt whichever persona is most likely to earn reward in a given context. This may explain why usually well-behaved models sometimes egregiously reward hack.
Read More →A sufficiently RL-trained model learns to adopt whichever persona is most likely to earn reward in a given context. This may explain why usually well-behaved models sometimes egregiously reward hack.
Read More →